Projet personnel · Outil expérimental
Outpainting vidéo
Élargir le cadre d’une vidéo en générant les zones manquantes, avec un objectif de cohérence d’une image à l’autre.
- Mon rôle
- Prototype et intégration
- Objectif
- Adapter le format d’une vidéo
- Difficulté
- Cohérence dans le temps
- État
- Expérimentation
Changer le format en gardant la scène
Le but était de pouvoir adapter une vidéo à un autre cadre en générant ce qui manque autour de l’image. Cela peut servir à élargir une vidéo 4:3 vers du 16:9, ou à préparer une composition verticale à partir d’un plan horizontal.
Mon prototype s’est d’abord concentré sur le second cas : placer la vidéo horizontale au centre d’un cadre vertical et générer les bandes au-dessus et en dessous. L’exemple 4:3 vers 16:9 ci-dessous explique le principe général ; il ne représente pas un résultat mesuré de mon code.
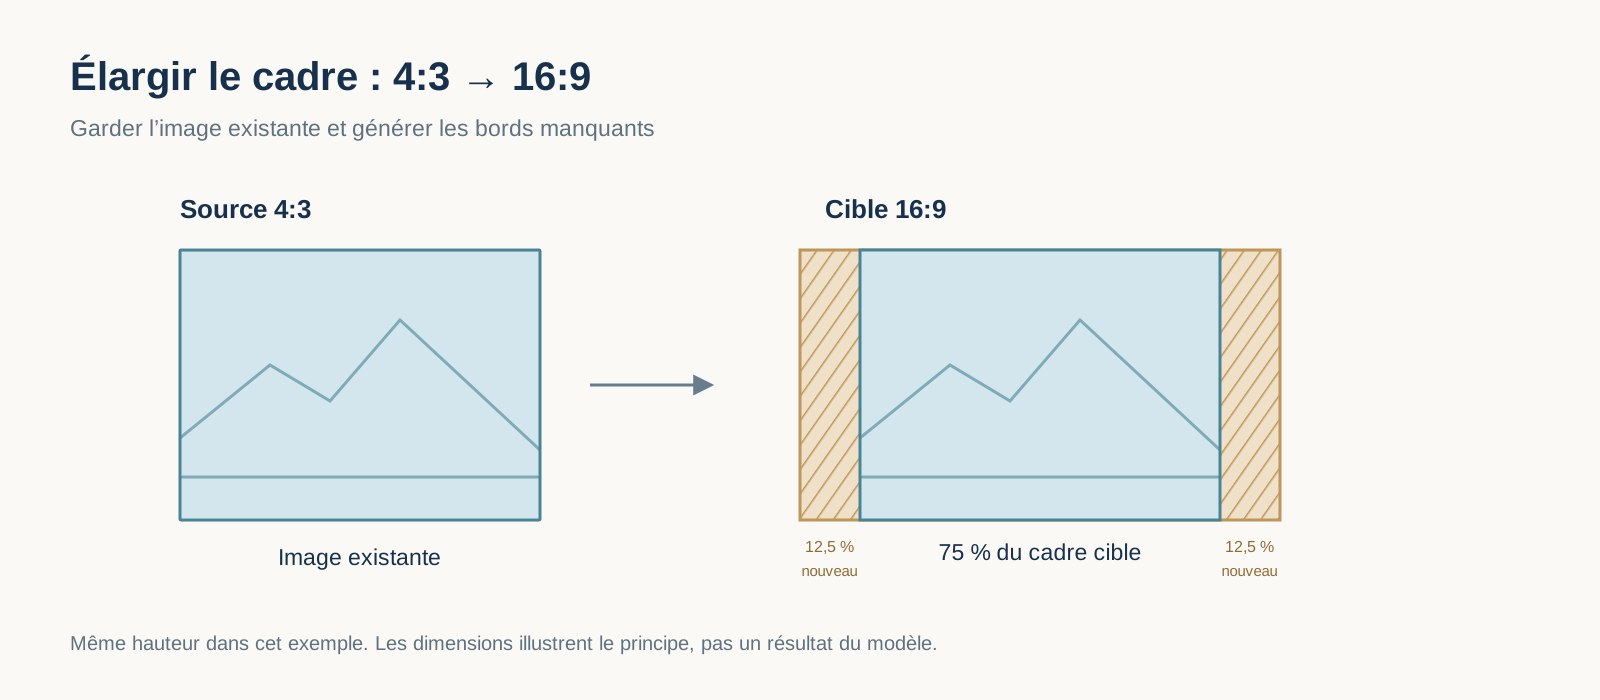
À quoi ressemble l’outpainting vidéo ?
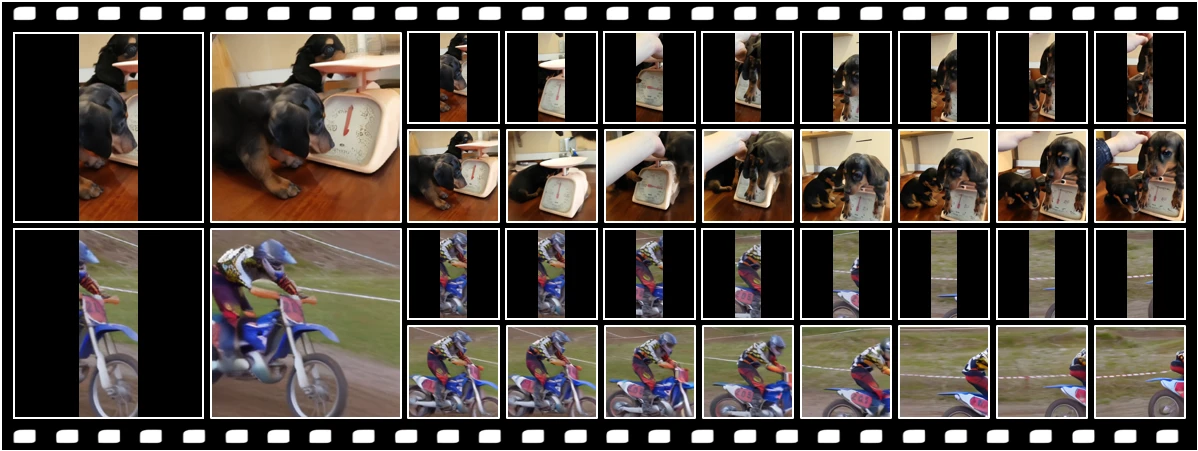
Les visuels de Seen-to-Scene permettent de voir le principe sur de vraies séquences : le contenu observé reste reconnaissable tandis que le champ visible est prolongé. Les exemples ci-dessous viennent du projet de recherche d’InSeok Jeon et de ses coauteurs.
Ils illustrent le résultat que je cherchais à approcher, pas les sorties de mon prototype. Je n’ai pas implémenté ni entraîné Seen-to-Scene ; mon projet explore sa propre orchestration de diffusion et de propagation guidée par le mouvement.
Le vrai problème : faire tenir le décor dans le temps
Une seule image élargie peut être convaincante. Dans une vidéo, les textures, les objets et la lumière doivent aussi rester cohérents pendant que la caméra ou les sujets bougent. Générer chaque image séparément peut produire un décor qui change ou scintille.
Le pipeline utilise le mouvement estimé pour transporter l’image générée précédente et initialiser le remplissage suivant. Il calcule aussi un état de bruit latent propagé, mais cette version ne le transmet pas encore à l’appel d’inpainting. Cette partie du mécanisme de continuité prévu reste donc à terminer.
Assembler un pipeline que je peux inspecter
Le code sépare l’extraction des images, la préparation du canevas et du masque, le calcul du mouvement, la propagation, le remplissage et la reconstruction du clip. Il prévoit aussi une étape de réduction du scintillement et la remise en place de l’audio.
La génération s’appuie sur une intégration Diffusers d’inpainting. Un mode de remplissage déterministe permet de tester la plomberie du pipeline sans lancer le modèle. Les étapes sont configurables afin de pouvoir isoler un problème ou remplacer une implémentation.
Le parcours d’un clip dans le prototype
- Préparer — Extraire les images, créer le canevas et définir les zones à remplir.
- Propager et générer — Estimer le mouvement, transporter l’état précédent et remplir les zones manquantes.
- Inspecter et assembler — Collecter les diagnostics, appliquer le post-traitement et reconstruire la vidéo.
Ce que j’ai testé, et ce qu’il reste à atteindre
Un court essai conservé contient trois comparaisons entre images successives : une SSIM moyenne de 0,9239 et une erreur temporelle moyenne après transport de 3,5450. Ces valeurs servent à inspecter ce petit essai. Elles ne mesurent pas une qualité visuelle de « 92 % » et ne constituent pas une comparaison contrôlée avec une autre méthode.
L’objectif final reste un outil d’adaptation de format que je pourrais évaluer sur plusieurs scènes, avec le cadre source et les zones générées clairement identifiés. Il me faut encore des sorties représentatives sur des scènes variées pour juger le résultat visuel.
- Comparaisons dans le court essai
- 3
- SSIM moyenne · essai local
- 0,9239
- Erreur temporelle moyenne · échelle du code
- 3,5450