Data Scientist & ML Engineer · mars 2024–février 2025
Decathlon
Étudier ce que les jours fériés, la météo et les événements peuvent apporter aux prévisions de vente, à travers les covariables et la création de variables.
- Mon rôle
- Data Scientist & ML Engineer
- Lieu
- Croix / Lille, France
- Période chez Decathlon
- Mars 2024–février 2025
- Modèle étudié
- Temporal Fusion Transformer
Mon travail chez Decathlon
Chez Decathlon Digital, j’ai principalement travaillé sur les covariables de prévision : des informations comme les jours fériés, les vacances scolaires, la météo et les événements, qui peuvent aider à expliquer les variations de la demande. Mon travail portait sur la préparation de données externes, la création de variables et l’évaluation de leur intérêt pour les prévisions de vente.
J’ai commencé par un stage de mars à septembre 2024, puis continué à travailler chez Decathlon jusqu’en février 2025.
L’exemple présenté ci-dessous vient de mon rapport de stage et porte sur les variables de calendrier dans un modèle de prévision Temporal Fusion Transformer existant. Le périmètre détaillé de mon travail après le stage reste confidentiel. La plateforme de prévision relevait d’un travail d’équipe.
Construire des données de calendrier exploitables
Avant d’entraîner un modèle, il fallait trouver des sources de calendrier avec assez d’historique, des dates futures, le détail régional et un suivi des mises à jour. Avec l’aide de data stewards, j’ai comparé les données gouvernementales, Date Holidays, Workalendar et Open Holiday API.
J’ai ensuite rapproché les dates de calendrier des ventes hebdomadaires : nom du jour férié, date et position dans la semaine. La couverture des vacances scolaires variait selon les sources ; j’ai commencé cette partie de l’analyse avec la France et ses trois zones scolaires. Préparer des données comparables représentait une part importante du travail.
Des dates externes aux variables de prévision
- Sourcer — Vérifier la période couverte, le détail régional, la fiabilité et la maintenance.
- Aligner — Relier les dates à l’index des ventes hebdomadaires et à la zone concernée.
- Encoder — Transformer les jours fériés et les vacances en entrées du modèle.
Vérifier l’analyse avant d’enrichir le modèle
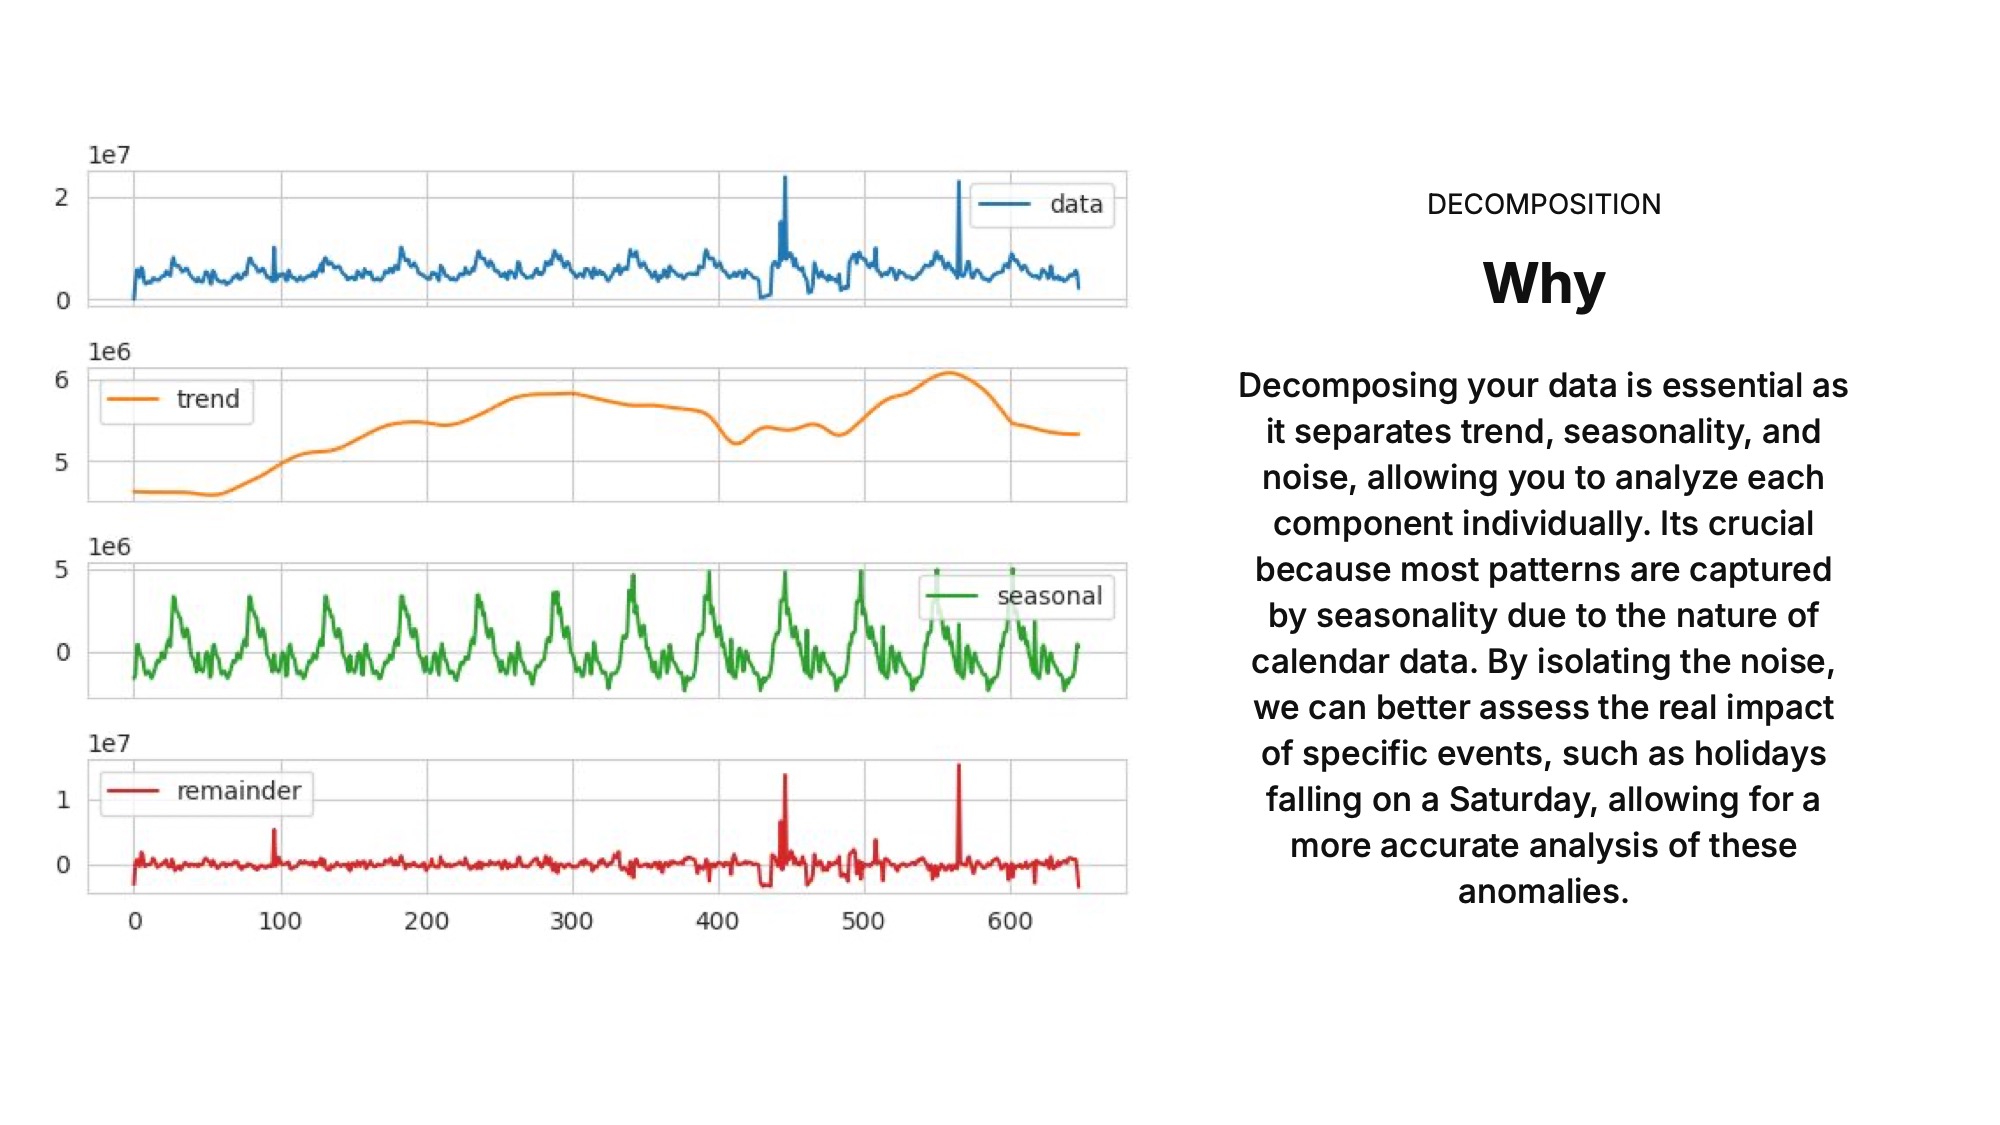
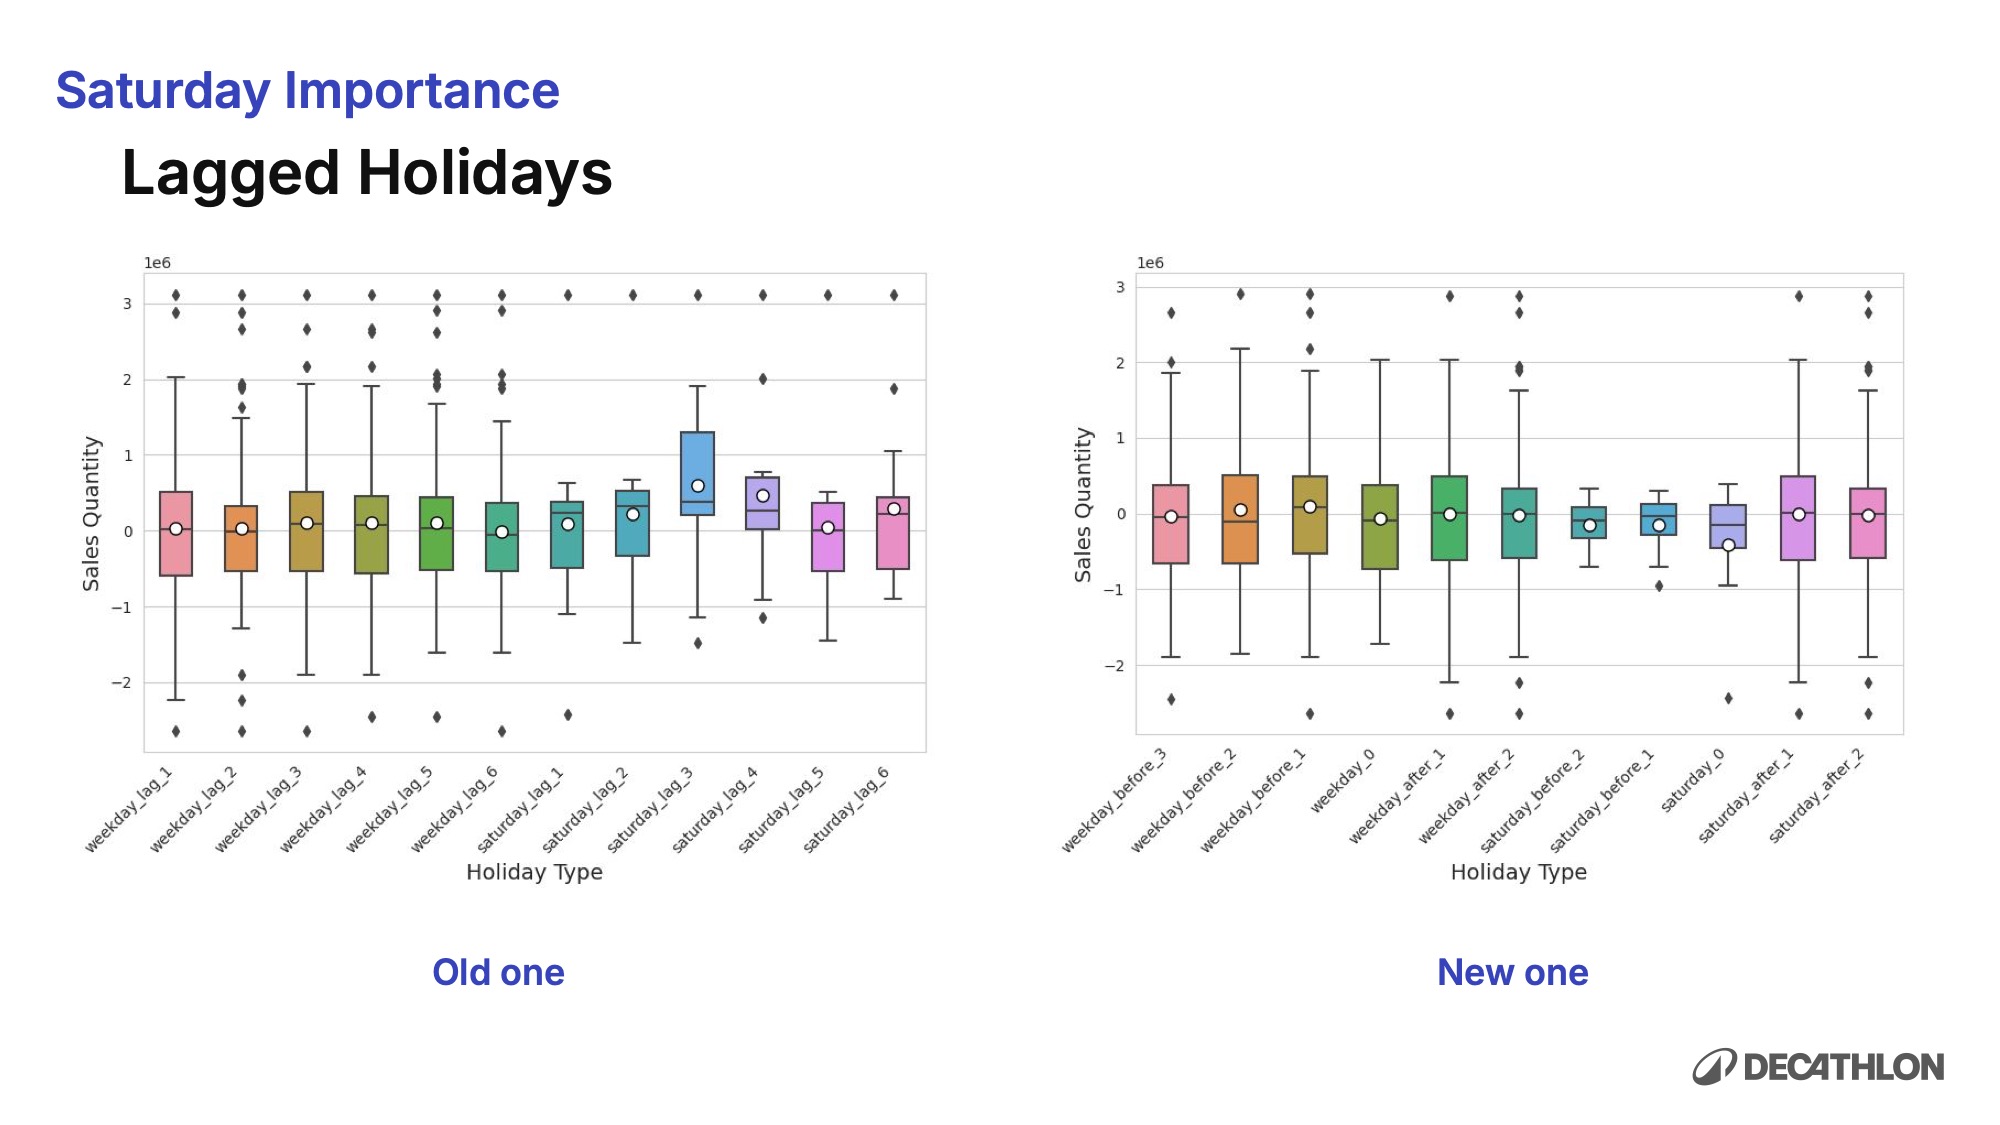
Un événement récurrent peut déjà être partiellement représenté par la saisonnalité. J’ai décomposé les ventes en tendance, composante saisonnière et résidus pour chercher l’information supplémentaire que pourraient apporter les variables de calendrier.
J’ai aussi dû revenir sur de premiers résultats. Un décalage apparent avant un jour férié a disparu après correction de l’implémentation. J’ai relancé les analyses et comparé des produits moins saisonniers ainsi que les ventes agrégées. Cette correction comptait : une explication séduisante du comportement d’achat ne suffisait pas à rendre une variable utile.
Transformer les dates en variables
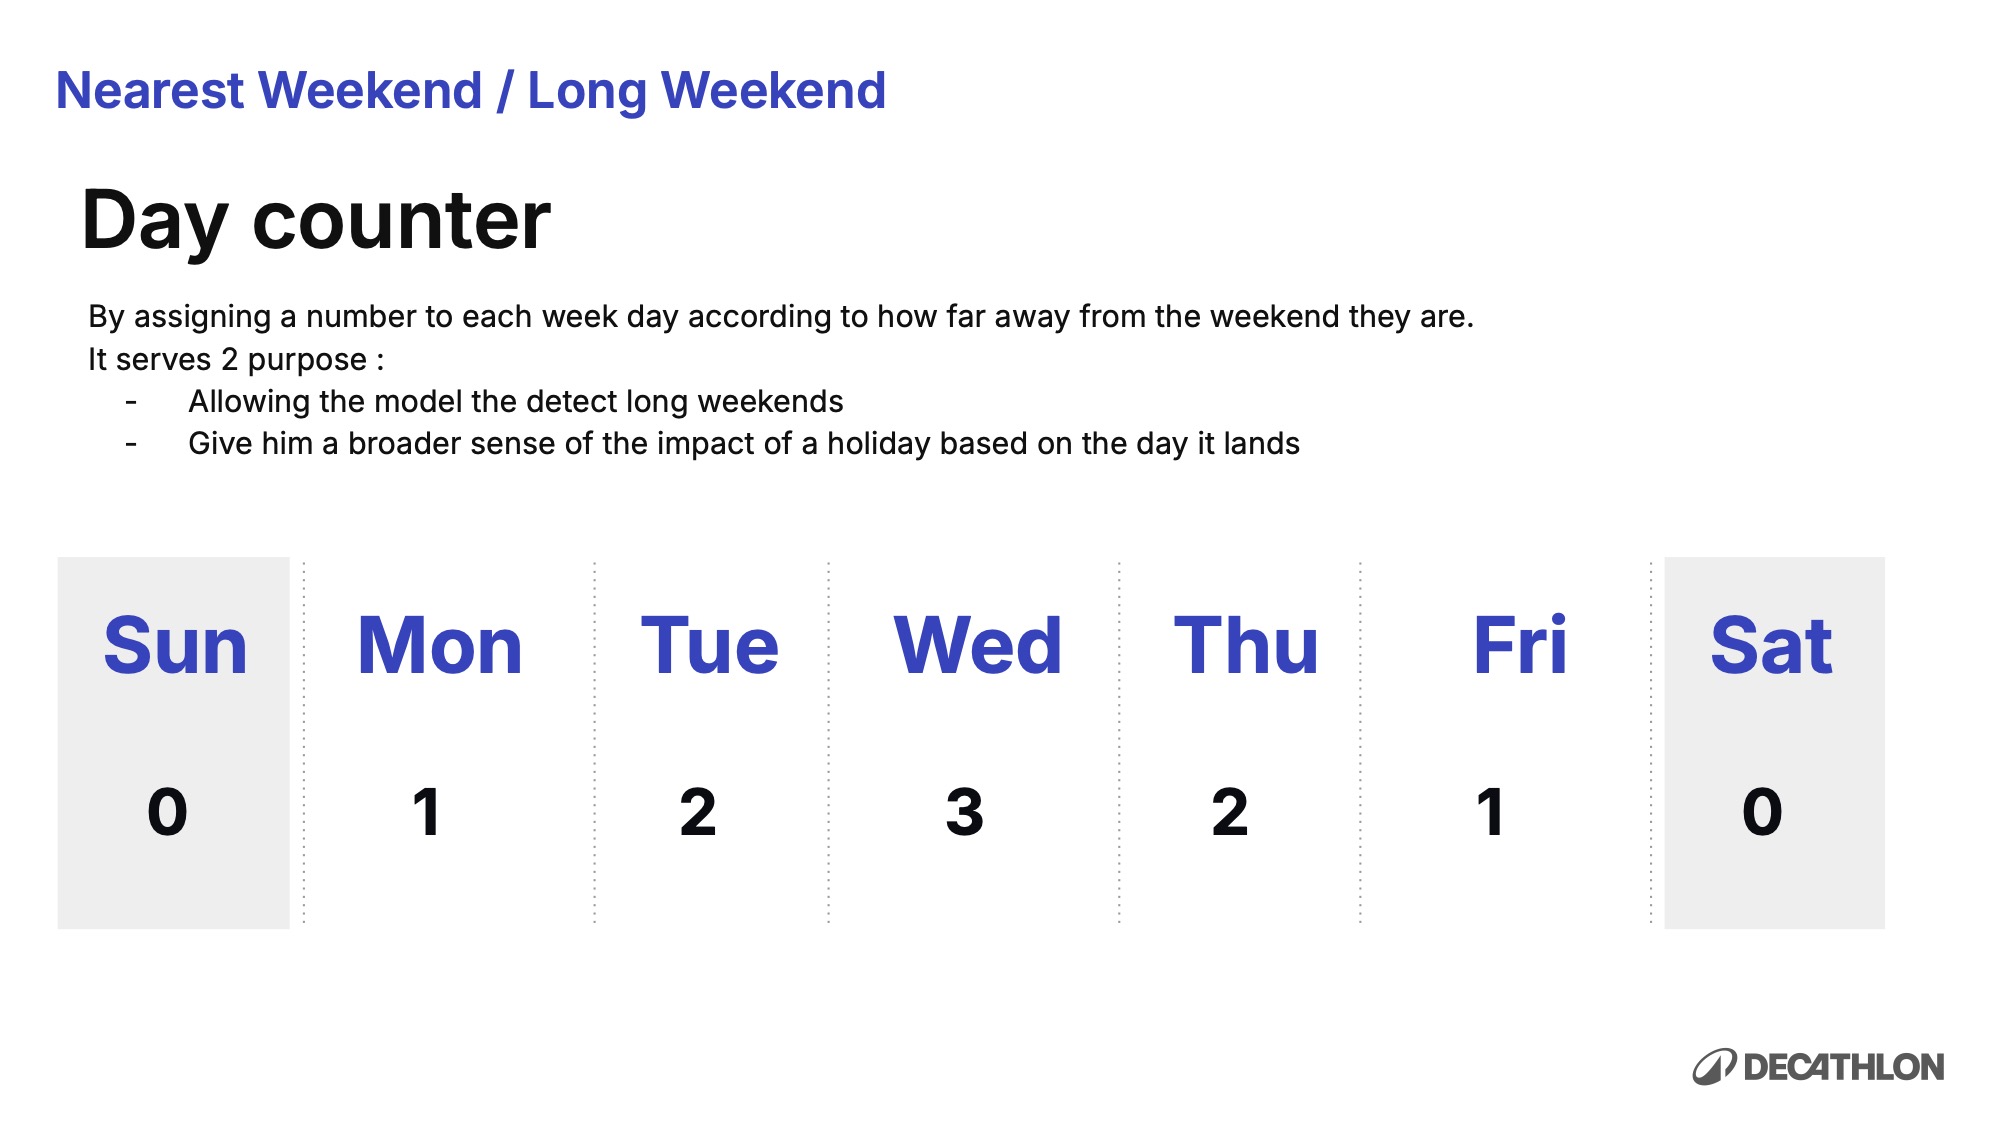
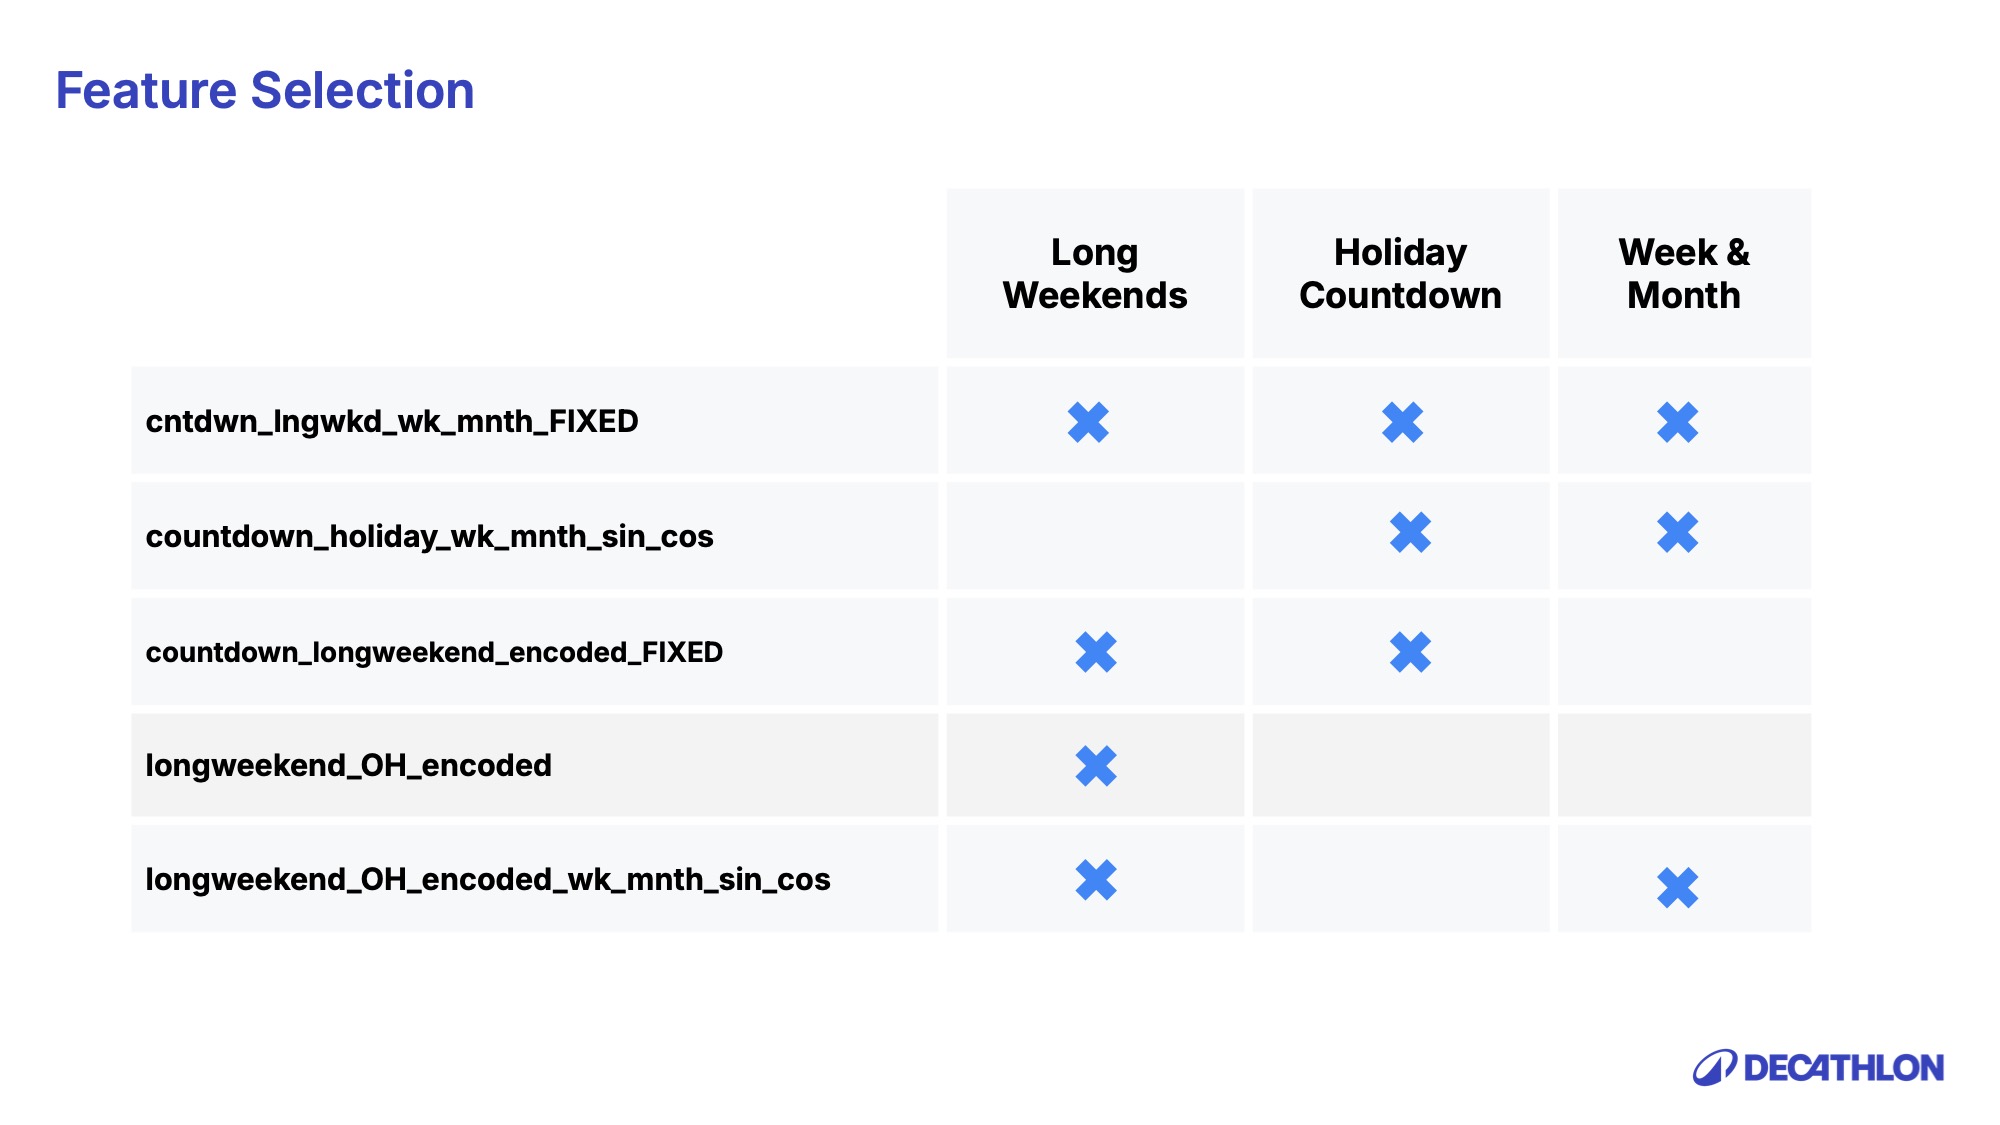
J’ai exploré les indicateurs de jours fériés, les longs week-ends et un compte à rebours jusqu’au prochain jour férié. Un Day Counter représentait la proximité du jour férié avec le week-end par une valeur de 0 à 3. Les expériences portaient aussi sur la semaine, le mois et les vacances scolaires françaises.
La manière de représenter l’information est devenue une expérience à part entière. Après les retours de l’équipe, j’ai comparé un encodage scalaire et un encodage one-hot, appliqué une normalisation MinMax au compte à rebours et testé des représentations sinus/cosinus de la semaine et du mois. Le modèle pouvait ainsi recevoir une même information sous plusieurs formes.
Évaluer, puis regarder ce que cache le score
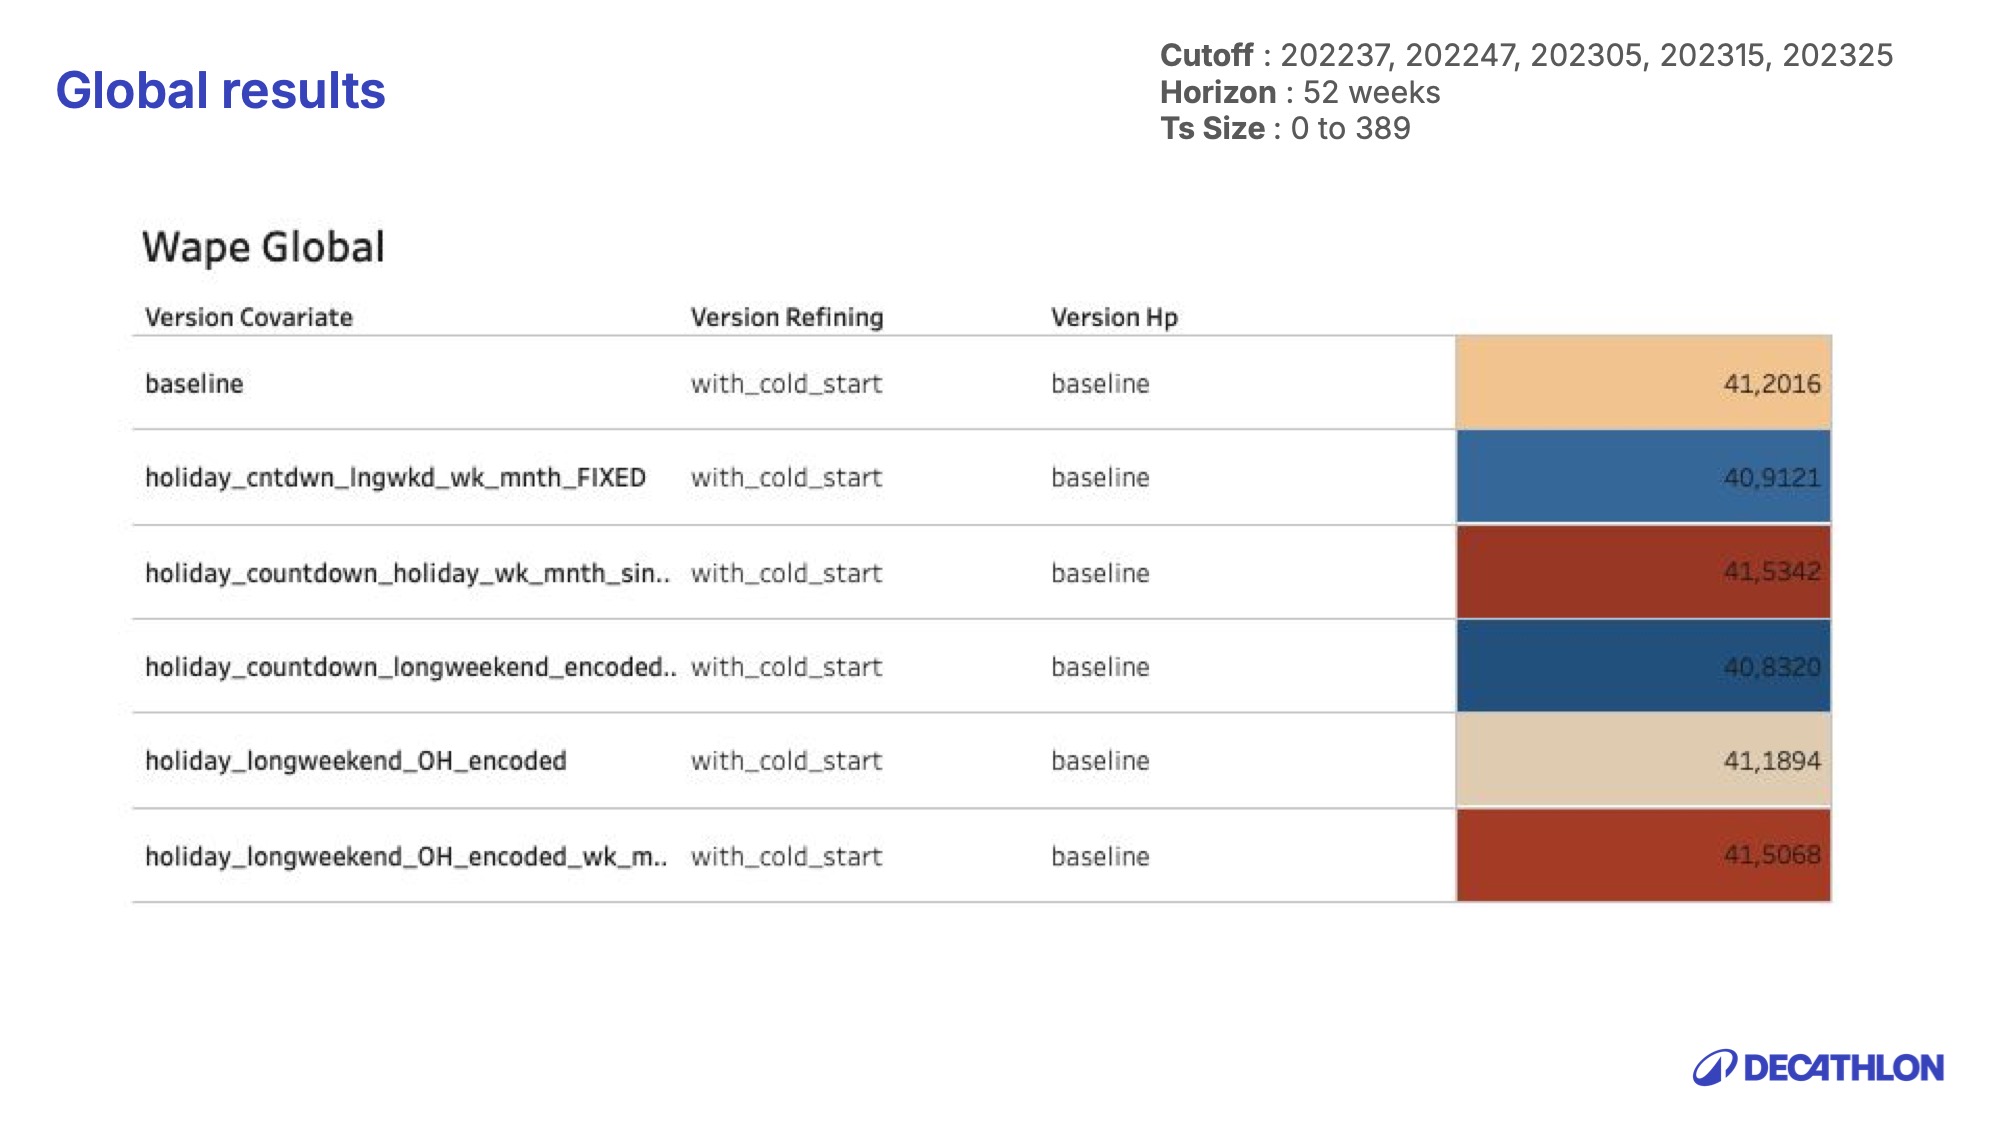
J’ai comparé les variantes au modèle de référence utilisé en production, dans une évaluation hors ligne. Le rapport décrit un horizon de prévision de 52 semaines et cinq dates de coupure : les semaines 37 et 47 de 2022, puis les semaines 5, 15 et 25 de 2023. Ces découpages permettaient d’examiner plusieurs périodes de l’année.
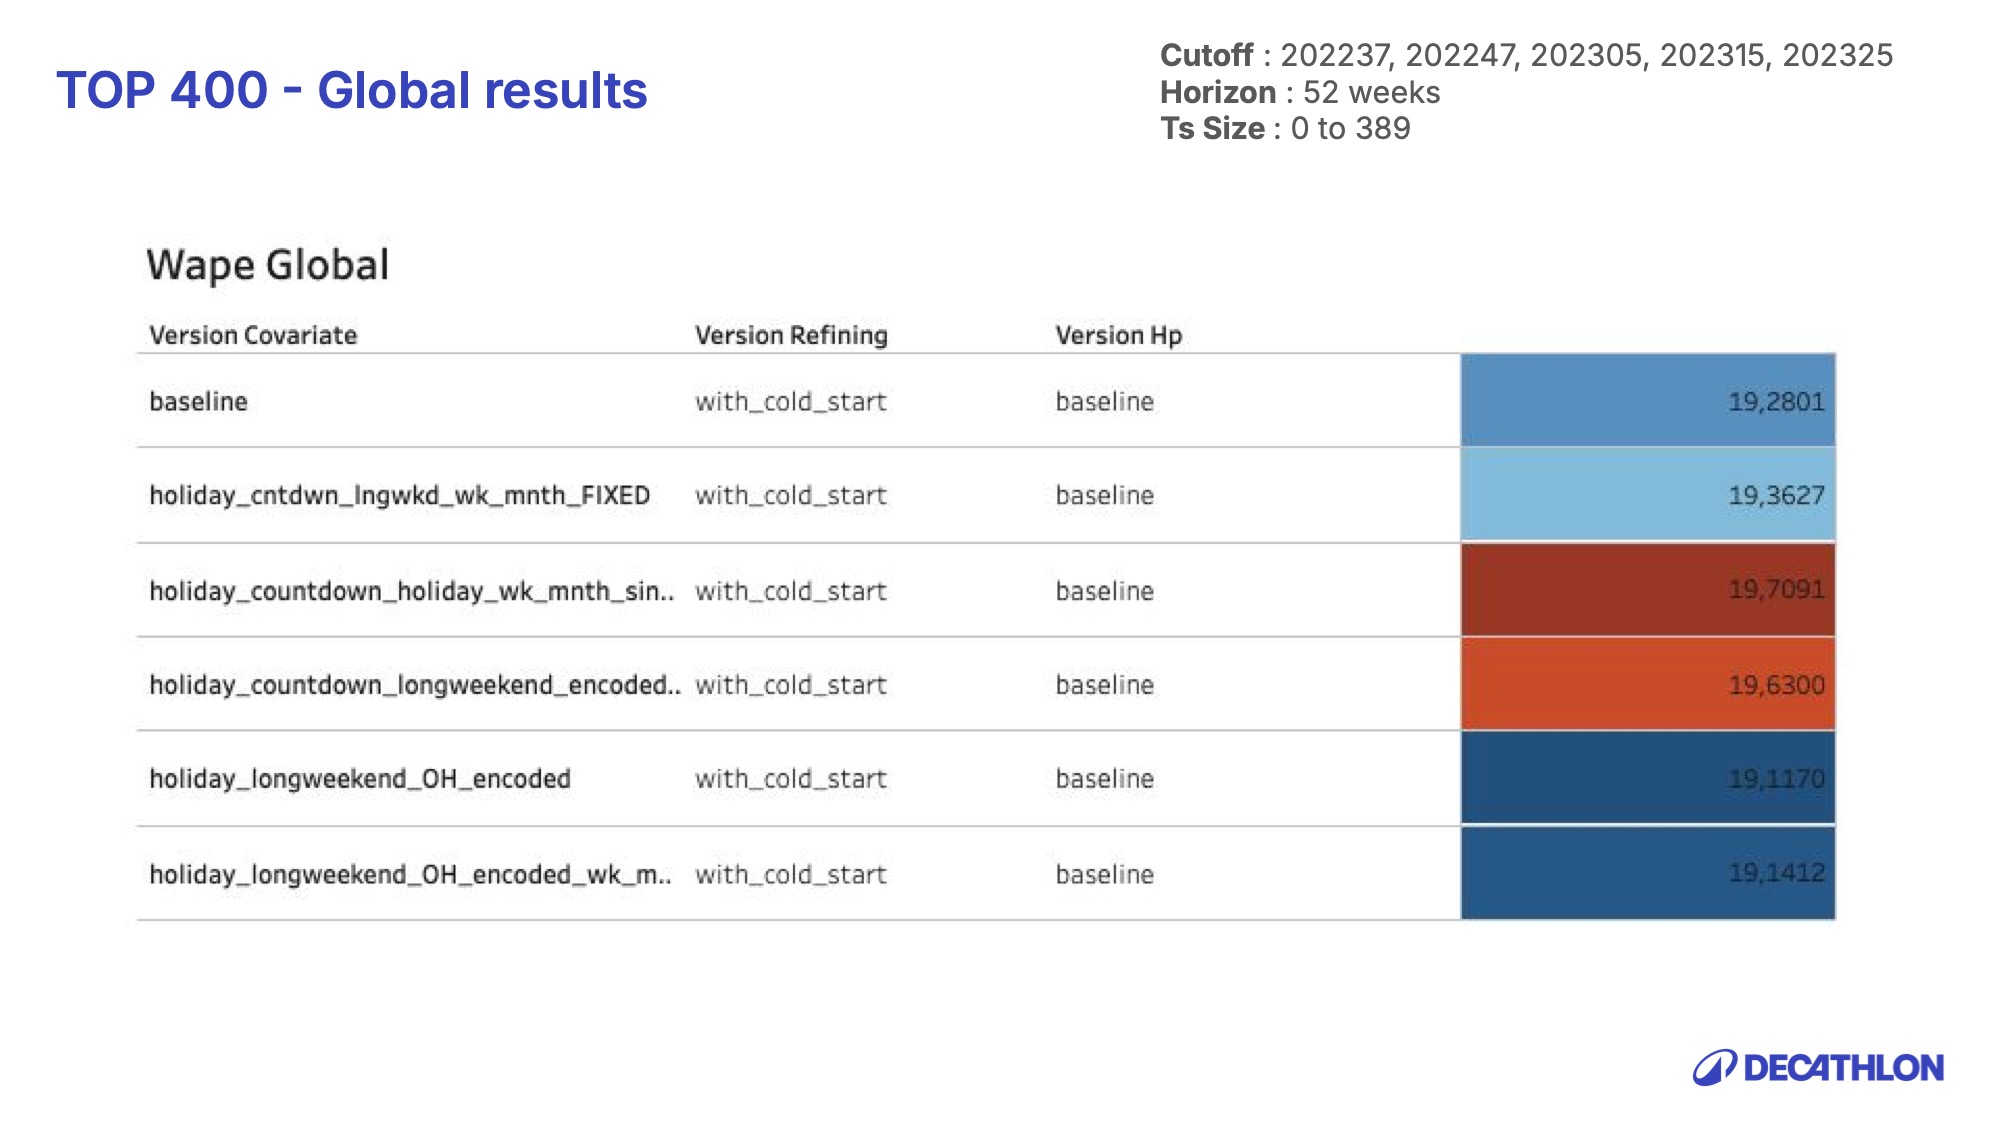
La première comparaison agrégée n’améliorait pas la référence, alors que l’analyse du Top 400 produits était plus prometteuse. J’ai ensuite revu les encodages et lancé un nouveau benchmark. Le rapport indique environ trois à quatre heures par entraînement : il fallait donc choisir et documenter les expériences avec soin.
Le déroulement de l’évaluation des variantes
- Comparer — Conserver le modèle de référence et l’horizon d’évaluation documentés.
- Décomposer — Examiner les dates de coupure, les groupes de produits et le Top 400.
- Revoir — Utiliser les résultats et les retours de l’équipe pour choisir le prochain encodage.
Un gain modeste, et un classement qui change
Le second benchmark global rapporte une WAPE de référence de 41,20, avec deux variantes à 40,91 et 40,83. Dans cette évaluation, une WAPE plus basse correspond à une erreur de prévision plus faible. Le meilleur résultat global affiché est donc inférieur d’environ 0,37 sur l’échelle de WAPE utilisée.
Ce résultat ne se retrouvait pas uniformément. La meilleure variante globale n’était pas la meilleure sur le Top 400 produits, où un autre encodage obtenait un meilleur score. C’était le point utile à retenir : une variable doit être évaluée en fonction des produits et des périodes auxquels elle est destinée.
- WAPE de référence
- 41,20
- Meilleure WAPE globale rapportée
- 40,83
- De moins sur l’échelle de WAPE
- 0,37
- Horizon de prévision
- 52 semaines
Interpréter pour choisir la suite
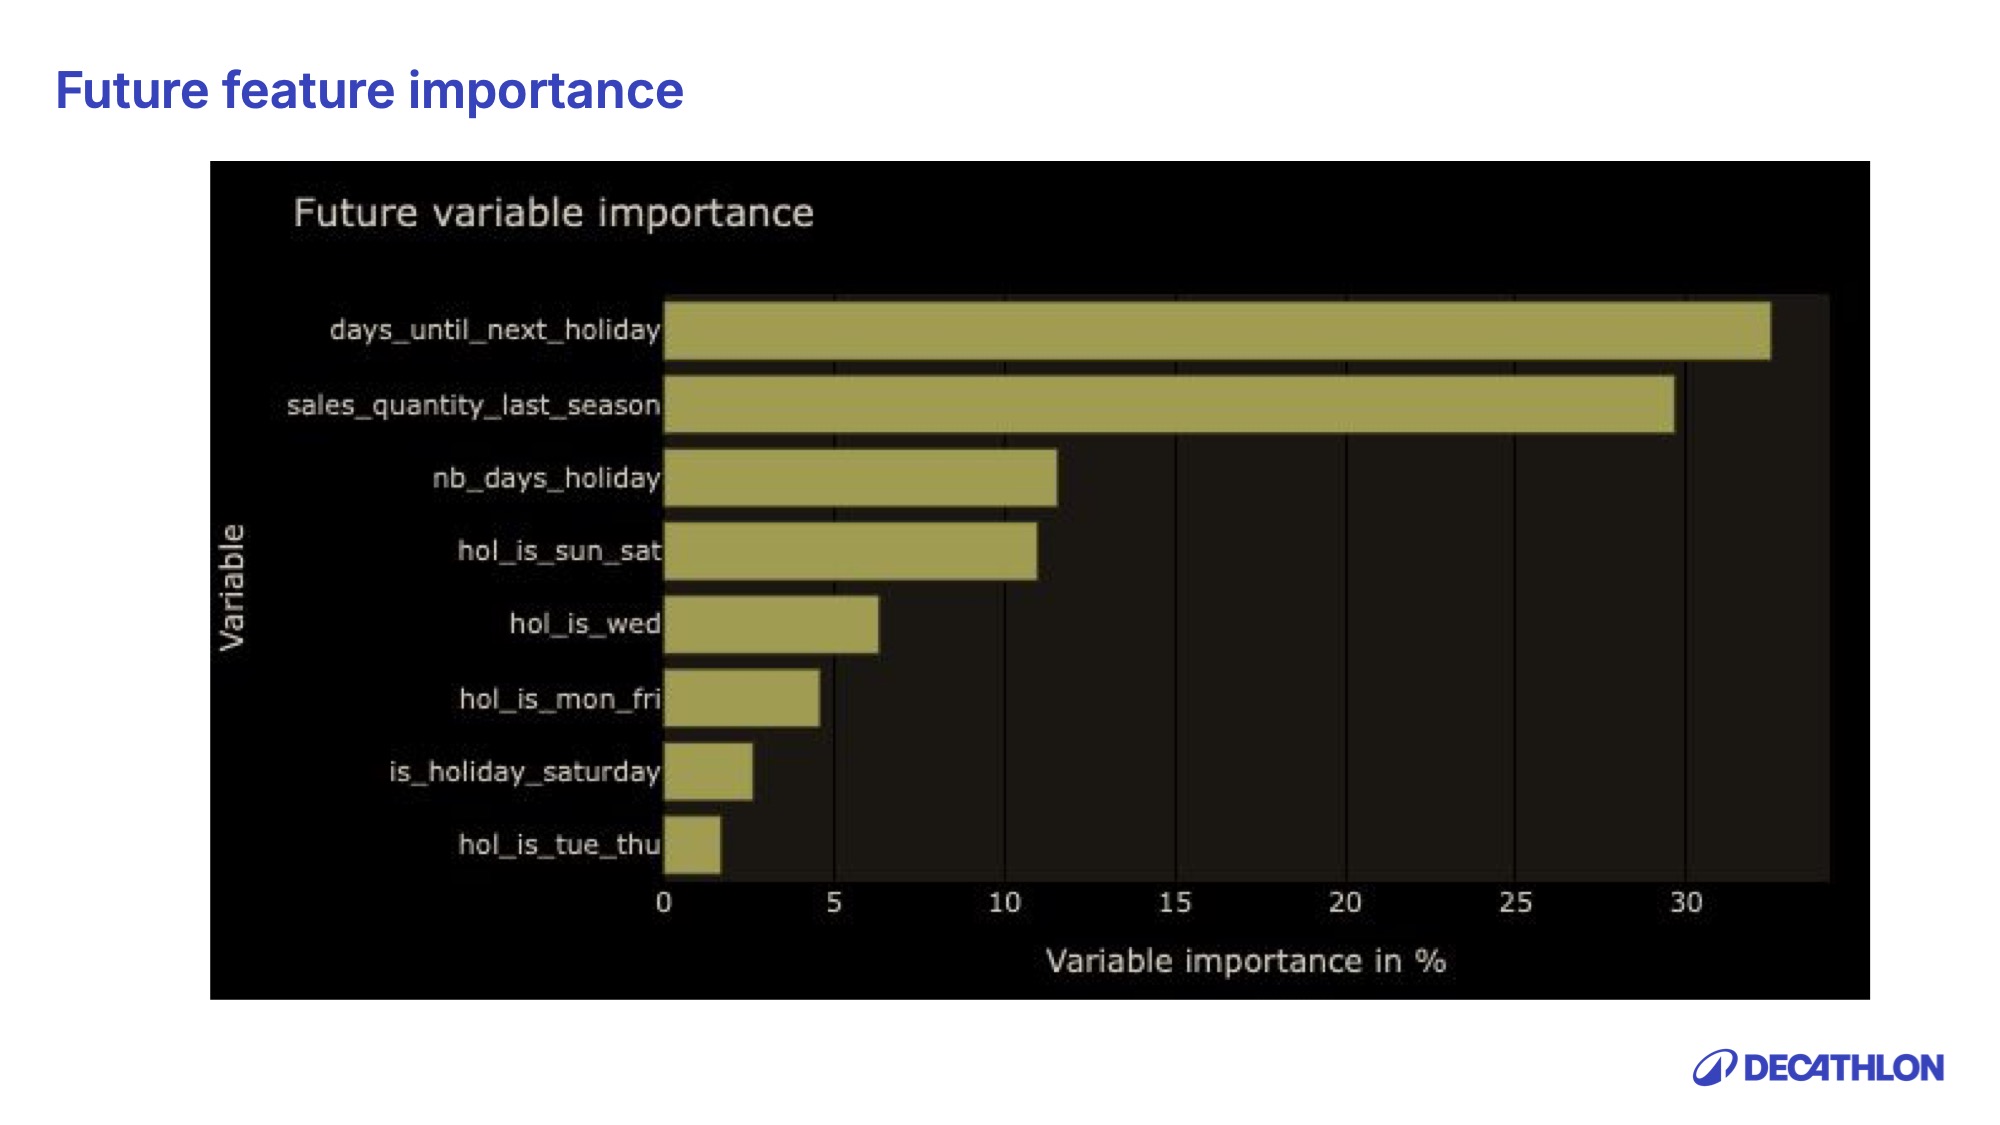
J’ai examiné l’importance des variables pour comprendre les entrées utilisées par le TFT. Le compte à rebours jusqu’au prochain jour férié se plaçait haut, avec les ventes de la saison précédente. C’était un indicateur utile pour comprendre le modèle ; l’évaluation des prévisions restait nécessaire, car un score d’importance ne démontre pas à lui seul un effet causal.
J’ai documenté le travail dans Confluence, suivi le fonctionnement de l’équipe sur Jira et présenté les résultats en anglais à une équipe internationale. Les retours ont directement orienté les essais d’encodage suivants. J’en retiens une façon plus rigoureuse de construire : formuler la question, vérifier les données et le code, mener la comparaison, puis expliquer dans quels cas le résultat tient.