Recherche personnelle · 2026
Recherche crypto
Plusieurs mois de modèles, d’analyse de portefeuilles et de trading simulé, jusqu’à remettre l’expérience elle-même en question.
- Mon rôle
- Recherche et développement personnels
- Période
- 2026 · plusieurs mois
- Données
- Bougies de 15 minutes · 22 tokens
- Trading
- Simulation · suivi Telegram
La question de départ
J'ai passé plusieurs mois à chercher si les données des marchés crypto pouvaient contenir un signal utile. Je voulais comprendre le problème par moi-même. J'ai donc construit des outils pour étudier le comportement de portefeuilles, entraîné des modèles sur les historiques de prix, exploré des textes de Reddit et fait tourner des bots de trading simulé suivis sur Telegram.
Construire les expériences
Le travail s'est développé sur plusieurs projets. L'analyse de portefeuilles passait par la collecte de transactions et la reconstitution de positions. Un pipeline de modélisation des prix utilisait des bougies de 15 minutes sur 22 tokens, avec environ 1,49 million de lignes enregistrées. Plus de 1 000 variables candidates ont été ramenées à 300 pour la modélisation.
Les expériences répondaient à des questions différentes. Prédire une direction future et reconnaître les conditions actuelles du marché sont deux tâches distinctes, même quand leurs scores apparaissent côte à côte. J'ai également étudié si les achats et ventes collectifs de gros portefeuilles apportaient un signal exploitable.
- Tokens étudiés
- 22
- Lignes de bougies enregistrées
- ≈ 1,49 M
- Variables sélectionnées
- 300
- Horizon de direction
- 4 h
Le résultat qui a changé la suite
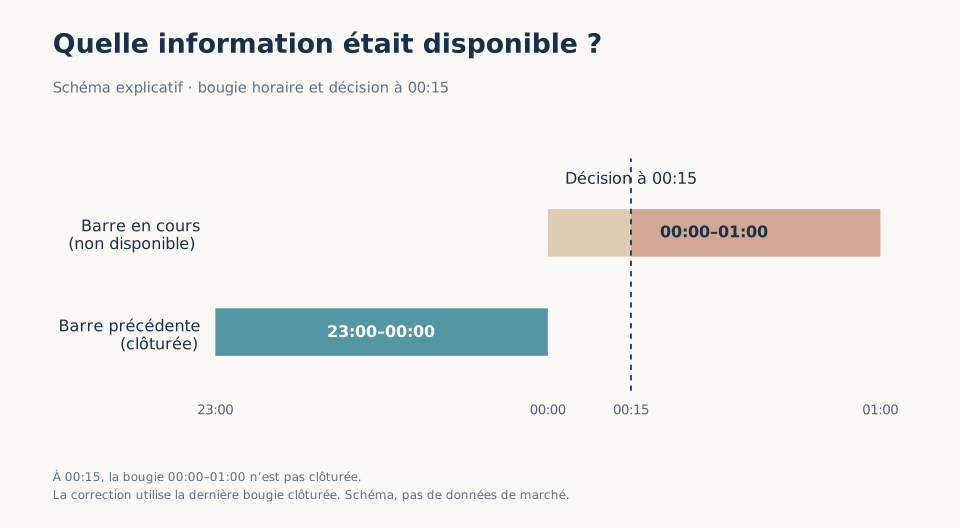
Certains premiers résultats semblaient très bons. La comparaison entre les calculs historiques et les informations disponibles pendant le trading simulé a révélé des données futures dans les variables. Des bougies horaires complètes étaient utilisées avant leur clôture, et une méthode de décomposition utilisait des données ultérieures pour calculer des valeurs passées.
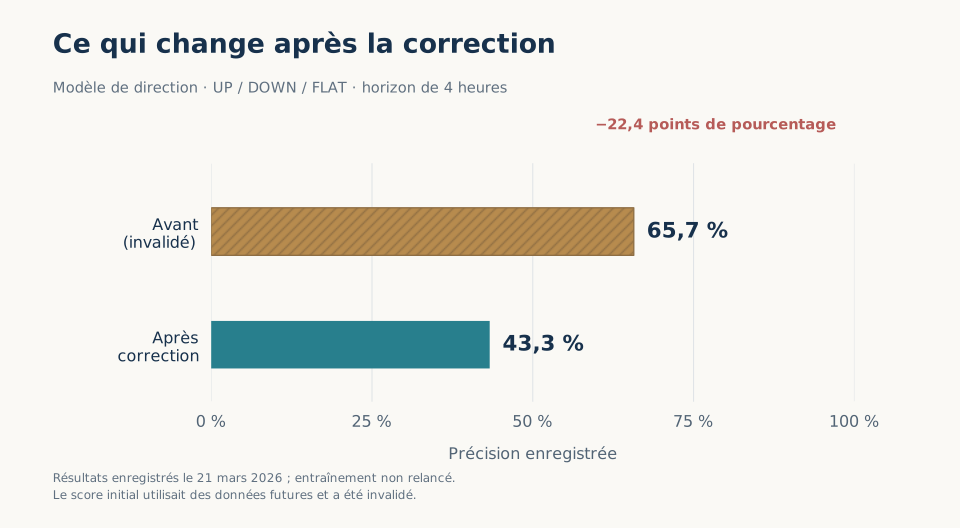
La correction s'appuyait sur les dernières bougies réellement clôturées et sur des fenêtres glissantes limitées au passé. Dans l'expérience enregistrée après cette correction, la précision sur la direction est passée de 65,7 % à 43,3 %. Cela changeait ce que je pouvais conclure du modèle.
- Avant correction · invalidé
- 65,7 %
- Après correction
- 43,3 %
- Écart de précision
- −22,4 points
Tester d’autres sources de signal
J’ai aussi étudié les flux collectifs de gros portefeuilles. Le rapport conservé examine 1 470 combinaisons de filtres de consensus ; aucune ne résiste à la correction statistique appliquée aux tests multiples. Le résultat concernait ce protocole, sans démontrer que tous les signaux de marché sont inutilisables.
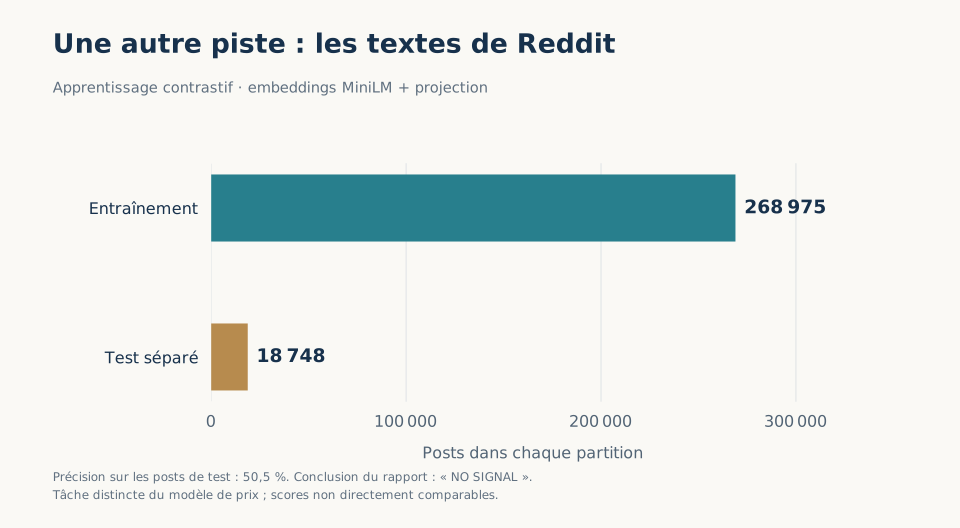
Une autre piste utilisait des embeddings MiniLM de textes Reddit et une projection apprise. Le rapport d’apprentissage contrastif porte sur 268 975 posts d’entraînement et 18 748 posts de test, avec une précision de 50,5 % sur les posts de test. Sa conclusion était « NO SIGNAL ». Cette tâche était distincte de la classification des prix en trois directions.
Suivre les gros portefeuilles en trading simulé
J’ai construit un bot qui surveillait une sélection de gros portefeuilles et utilisait leur activité pour déclencher des positions simulées, avec un suivi sur Telegram. La recherche sur les portefeuilles devenait une expérience complète : détecter un signal, ouvrir une position simulée, la suivre et enregistrer sa clôture.
Le suivi du bot affichait environ +28 SOL de résultat simulé. L’audit ultérieur a reconstitué +27,63 unités étiquetées SOL sur la dernière période après remise à zéro, du 13 avril au 18 mai 2026 : 1 367 positions clôturées appariées, pour un capital initial simulé de 11,81 unités. Le filtre de suivi initial affichait +28,40 ; la normalisation des dates a réintégré des pertes supplémentaires.
C’était une étape encourageante après plusieurs mois de recherche : le système de suivi des gros portefeuilles tournait et produisait un résultat positif dans sa propre simulation. J’ai ensuite examiné ce que ce résultat devait aux hypothèses du simulateur et à quelques gains exceptionnels enregistrés.
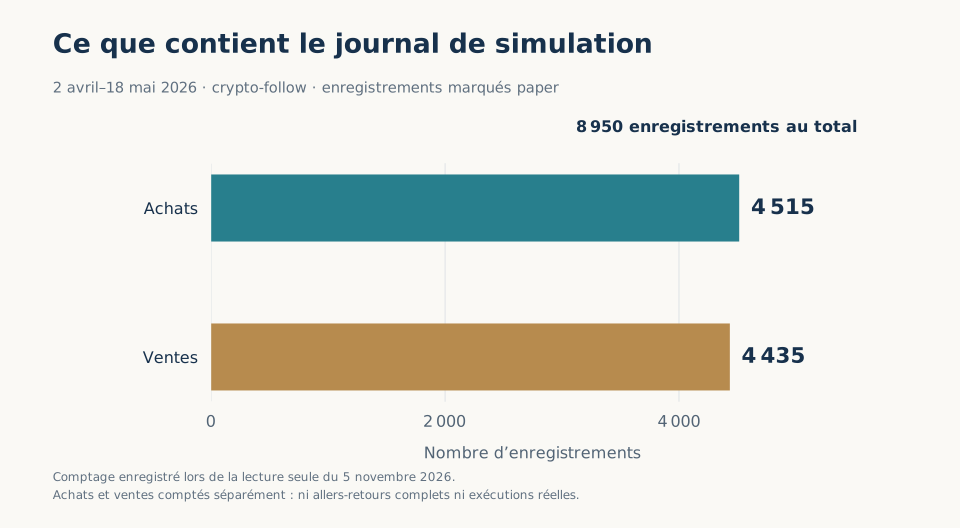
Le journal crypto-follow complet contient 4 515 achats et 4 435 ventes du 2 avril au 18 mai 2026, tous marqués comme simulés. Ces 8 950 lignes comptent les achats et les ventes séparément et couvrent une période plus large que le résultat après remise à zéro. Le code les reliait à des alertes Telegram étiquetées [PAPER].
- Résultat simulé · unités étiquetées SOL
- ≈ +28
- Positions clôturées appariées · période finale
- 1 367
- Capital initial simulé · unités SOL
- 11,81
Vérifier ce que mesure le simulateur
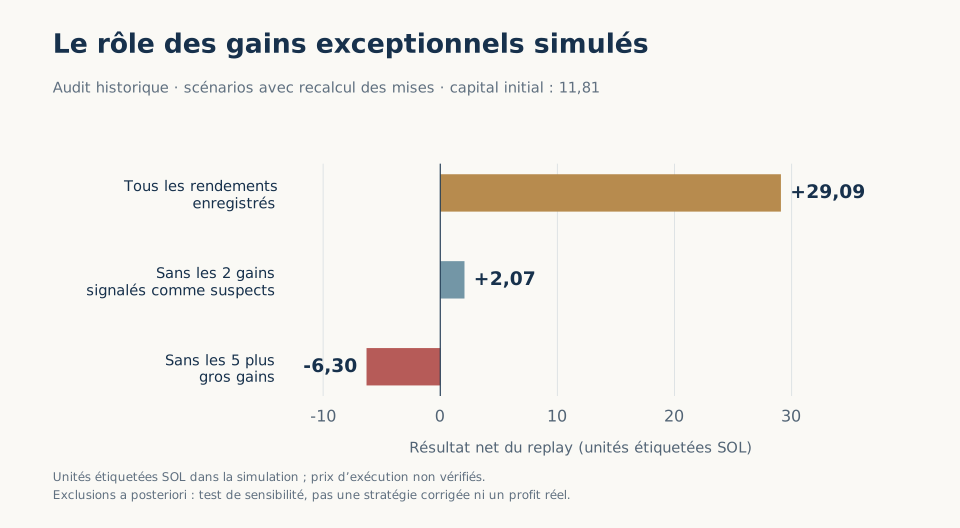
Un audit historique conservé a ensuite mis en évidence des limites de comptabilité, de conversion monétaire et de prix d’exécution simulés. Une simple correction du calcul de trésorerie ne suffisait pas à valider la stratégie : certains gains exceptionnels dominaient encore les résultats.
Dans un replay avec recalcul des mises, le résultat enregistré passe de +29,09 unités étiquetées SOL à +2,07 en excluant deux gains signalés comme suspects, puis à −6,30 sans les cinq plus gros gains. Ce sont des exclusions choisies après observation, sur des rendements dont les prix d’exécution restent non vérifiés. Elles servent à mesurer la sensibilité du résultat, pas à annoncer un bénéfice réel ou une stratégie corrigée.
J'ai ensuite adapté un framework existant de recherche automatisée pour organiser les essais autour d'un jeu de données fixe, de références de comparaison et de règles plus explicites. La fiabilité de l'expérience est devenue un sujet aussi important que le choix du modèle.
Le journal de cette adaptation contient 384 entrées : références, essais, échecs et restaurations de candidats. Ce n’est pas un décompte de 384 expériences indépendantes réussies. Les comparaisons doivent rester dans une même définition de cible.
Ce que j'en retiens
Ce projet me ressemble particulièrement. J'ai suivi une question assez longtemps pour comprendre pourquoi certaines réponses prometteuses ne tenaient pas. J'y ai développé mes compétences en traitement des données, en modélisation et en débogage, tout en devenant plus attentif à ce qu'un résultat démontre réellement.
Les chiffres présentés proviennent des comptes rendus d'expériences conservés. Ils décrivent ces essais, pas une performance prédictive actuelle ni une stratégie de trading rentable.